Come localize.dev riscrive le stringhe hardcoded senza interrompere il tuo codice
Ciò che il motore considera testo dell'interfaccia utente, come modifica un file senza riformattarlo, cosa si rifiuta di indovinare e perché una seconda esecuzione non cambia nulla.
Stephen Ufort · 12 novembre 2026 · 5 min di lettura
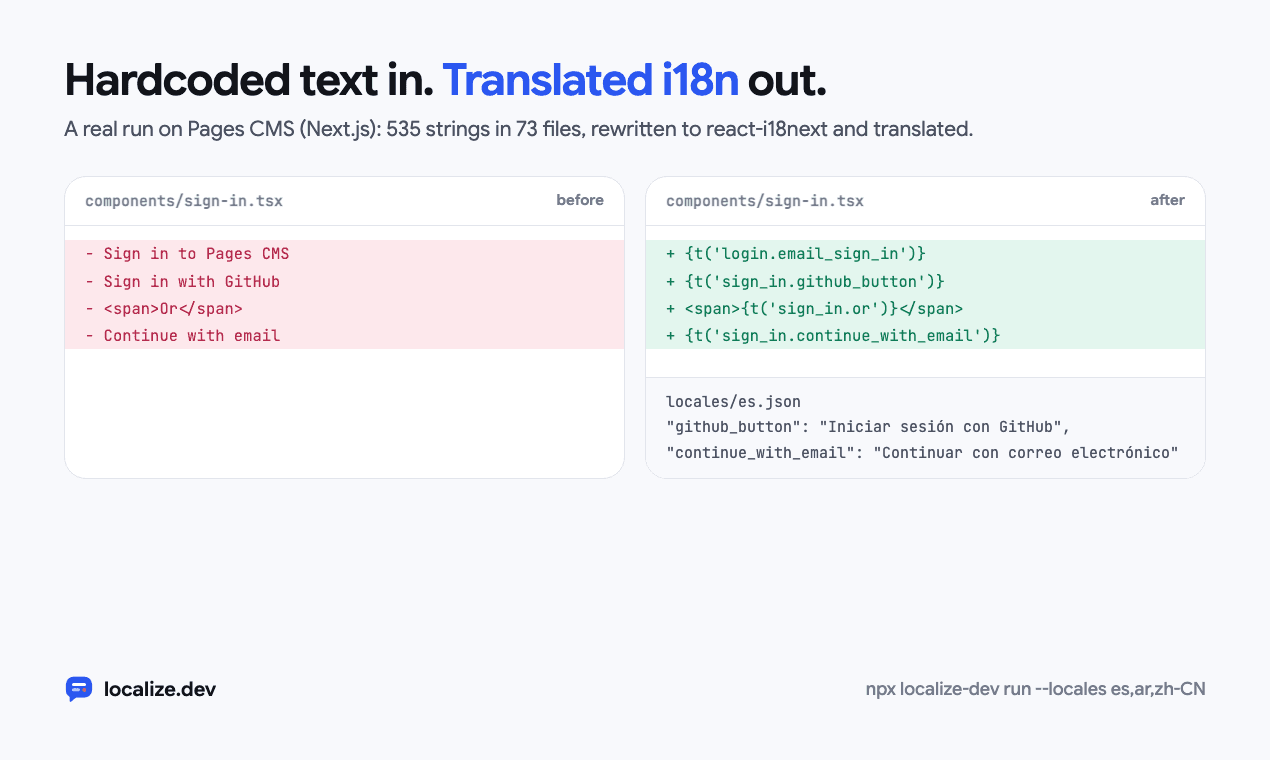
Pages CMS è un'app Next.js open-source senza i18n. Un'esecuzione di npx localize-dev run --locales es,ar,zh-CN ha spostato 535 stringhe in 73 file su react-i18next: 395 nuove chiavi, più 140 posizioni che hanno riutilizzato una chiave perché lo stesso testo ne aveva già una. TypeScript è stato compilato prima e dopo l'esecuzione. Due messaggi di validazione sono stati saltati e la pull request li elenca con il motivo.
Puoi consentire a uno strumento di modificare solo 73 file se ti fidi della differenza. Questo post copre come il motore decide cosa cambiare, come effettua la modifica e quando si ferma e lascia la decisione a te.
Le regole riscrivono il codice; un modello nomina le chiavi e traduce
Tutto ciò che tocca i tuoi file sorgente è codice deterministico. Il modello ha due compiti: proporre un nome chiave come settings.notifications_heading e tradurre. Non vede mai un file intero e non ne modifica mai uno, quindi non può riformattare il tuo codice, rinominare una variabile o eliminare un'importazione.
Trovare il testo che le persone vedono
Ogni file passa attraverso un parser per il suo stack. JSX e TSX passano attraverso @babel/parser. I template Vue, Svelte, Angular, Astro ed Ember passano attraverso il compilatore di ciascun framework, e l'HTML semplice attraverso parse5. I tag ERB, Django e Blade vengono prima tokenizzati e mascherati, e poi la pagina passa anche attraverso parse5. Il codice Swift, Dart e Android viene letto con lexer più piccoli scritti a mano.
Una stringa nell'albero sintattico non è automaticamente testo dell'interfaccia utente. La regola principale riguarda dove finisce. Un letterale conta quando raggiunge un figlio JSX, o un attributo che le persone leggono come placeholder, alt, title o aria-label, e può passare attraverso un ternario, &&, || o parentesi lungo il percorso. Un nome di classe non ci arriva mai, né un argomento per console.log o per una chiamata di analisi.
Questo componente proviene dalla suite di test dello scanner. Di tutte le stringhe al suo interno, lo scanner ne estrae una:
const A = ({ x }) => {
  console.log(`debug ${x}`);
  const label = 'Not in JSX';
  return <div className={`btn ${x}`} onClick={() => track('Clicked')}>
    <code>npm i</code><pre>raw</pre>
    <span translate="no">Brand</span>
    <div data-i18n-ignore><p>Skip me</p></div>
    <Trans>Already done</Trans>
    {t('existing.key')}
    {x ? 'primary' : 'secondary-btn'}
  </div>;
};
// extracted: ['primary']
Entrambi i rami del ternario raggiungono l'output, ma secondary-btn fallisce un secondo set di filtri che esaminano il valore stesso. Gli ID snake, kebab e puntati non contano mai, così come URL, percorsi, colori, email, nomi di file, prezzi, versioni o elenchi di classi. Il testo all'interno di code, pre o <Trans>, o sotto translate="no" o data-i18n-ignore, viene lasciato invariato.
Alcuni testi raggiungono le persone tramite codice anziché markup: toast(), alert(), confirm(), document.title, e messaggi di validazione negli schemi zod o yup. Lo scanner li riconosce dalla chiamata a cui vengono passati.
Modifica senza ristampare il file
Il modo consueto per riscrivere il codice è cambiare l'albero sintattico e stamparlo di nuovo, il che riformatta tutto ciò che la stampante tocca. localize.dev non stampa mai l'albero. Prende gli offset segnalati dal parser e inserisce ogni modifica nel testo originale con magic-string, in modo che ogni riga che non modifica mantenga la sua formattazione esatta, commenti inclusi.
Ecco un piccolo componente e ciò che il motore scrive per esso. Le chiavi qui sono state nominate offline; in un'esecuzione reale, il modello le nomina.
export function Settings({ user }) {
  return (
    <section className="settings">
      <h2>Notifications</h2>
      <p>Signed in as {user.email}</p>
      <input placeholder="Search settings" />
      <p>Read the <a href="/help">help center</a> before you change these.</p>
    </section>
  );
}import { useTranslation, Trans } from 'react-i18next';
export function Settings({ user }) {
const { t } = useTranslation();
return (
<section className="settings">
<h2>{t('settings.notifications')}</h2>
<p>{t('settings.signed_in_as', { email: user.email })}</p>
<input placeholder={t('settings.search_settings')} />
<p><Trans i18nKey="settings.read_the_help_center_before" components={{ a: <a href="/help" /> }} /></p>
</section>
);
}{user.email} è diventato un valore denominato, quindi i traduttori vedono Signed in as {{email}} e possono spostarlo. La frase con il link è rimasta intera come un unico messaggio <Trans>, perché un traduttore ha bisogno dell'intera frase per posizionare il link nel posto giusto.
Portare t nello scope segue il codice già presente. Viene riutilizzato un const { t } = useTranslation() esistente nella funzione. Altrimenti, la riga dell'hook va prima della prima istruzione e viene aperto un corpo di freccia corto per farvi spazio. I componenti server di Next.js ottengono await getTranslation() e diventano async; i componenti di classe ottengono withTranslation(). L'importazione va dopo la tua ultima importazione, e solo se manca.
Quando non indovina
Alcune stringhe non possono essere riscritte in sicurezza. Queste vengono saltate e elencate con un motivo. Un messaggio in uno schema creato al di fuori di qualsiasi componente non ha t da chiamare in quel punto, motivo per cui le due stringhe di Pages CMS sono state saltate. Altri motivi includono una t che significa già qualcos'altro in quella portata e una costante che viene esportata o letta da più di un componente, dove modificarla potrebbe interrompere gli altri lettori.
Le stringhe saltate appaiono nella pull request sotto "Stringhe saltate", e localize-dev check continua a segnalarle finché qualcuno non le sposta.
Eseguirlo due volte non cambia nulla
Dopo un'esecuzione, il testo è t('key'). Una stringa passata a t() non raggiunge l'output come letterale, quindi lo scanner non la rileva di nuovo. La pipeline accoda solo le stringhe che non hanno una chiave, o le chiavi a cui manca una traduzione, e i file il cui contenuto è rimasto invariato vengono esclusi dal risultato. La suite di test esegue il motore sul proprio output e non si aspetta modifiche.
Controllo delle traduzioni prima che vengano scritte
Ogni traduzione viene controllata rispetto alla sua origine: segnaposto, tag di markup e ogni forma plurale di cui la lingua ha bisogno, sei per l'arabo e una per il giapponese. A una traduzione che fallisce viene richiesta un'altra volta con il motivo allegato. Se fallisce di nuovo, viene omessa e segnalata, mai scritta. Un post separato copre questo in dettaglio.
Cosa lascia il tuo dispositivo
Il parsing e la riscrittura vengono eseguiti sulla tua macchina o sul tuo runner CI. Per ogni stringa, il modello riceve il testo con i suoi segnaposto, il percorso del file e un breve suggerimento come "placeholder" attribute on <input> in component <Login>. Non riceve il tuo codice sorgente. Le esecuzioni di check, scan e --offline non inviano nulla.
Cosa non fa
- L'output di React e Next.js è react-i18next. Se la tua app utilizza già react-intl, next-intl o Lingui, localize.dev non scriverà su di essi.
- Swift, Dart e Android vengono letti con lexer, non con i loro compilatori.
- Le stringhe che non riesce a posizionare sono elencate e spostarle spetta a te.
Se ha sbagliato il tuo codice, mi piacerebbe vedere il file. Il playground esegue questo motore sul codice che incolli, senza account.
Provalo sul tuo codice nell'area di gioco, non è necessario un account